INTERLIS leicht gemacht #69 - IBX: INTERLIS kann auch binärº
2026-09-28
Warum noch ein Format?
(Ja, ich kenne das Meme.)
Im Umfeld des DMAV wird immer noch über die «Einbindung von Geodiensten» diskutiert. Ich bin mir nicht sicher, ob man sich dabei ausreichend Gedanken gemacht hat, was das konkret bedeutet. Oder ich habe es nie wirklich verstanden, was die zuständigen Personen eigentlich wollen und meinen. Die Schwierigkeit ist doch, dass irgendein Dienst mit z.B. LFP2 von Kanton X inhaltlich und strukturell völlig anders aussehen kann als vom Kanton Y. Wie soll das zusammen überhaupt irgendwie funktionieren? (Remember: geodienste.ch mit WFS-Integration?)
Diese Frage hat man sich vor über zehn Jahren auch schon einmal gestellt und sogar Antworten gefunden. Die Kantone haben zusammen mit dem Bund die sogenannten «Handlungsanweisungen für die modellkonforme Bereitstellung von Geodaten mittels Download-Diensten gemäss GeoIG» erarbeitet. Man darf ihnen eine gewisse Theorielastigkeit und Irrelevanz vorwerfen, aber sie haben damals viel zu einem gemeinsamen (KKGEO, KOGIS) Verständnis beigetragen.
Das Paper postuliert drei Bereitstellungen, die modellkonform sind:
-
INTERLIS/GML via Atom + OpenSearch
-
INTERLIS/XTF via Atom + OpenSearch
-
INTERLIS/GML via OGC WFS 2.0.0
Man wusste meines Erachtens bereits damals, dass die dritte Variante bedeutungslos ist, weil zu kompliziert. Das INTERLIS/GML-Format hat sich auch nie durchgesetzt. Warum auch? Bleibt also noch INTERLIS/XTF via Atom + OpenSearch. Atom + OpenSearch war jetzt auch nicht der Brüller, das spielt aber keine Rolle, da es einfach mit STAC ersetzt werden kann. Also gibt es heute faktisch noch eine Variante.
Nun hat INTERLIS/XTF seine Vorteile aber es ist sicher kein benutzerfreundliches »Gebrauchsformat«. Benutzer möchten die Datei einfach nach QGIS drag 'n' droppen und gut ist. Weil es eine OGR-Treiber gibt, geht das so halbwegs, bleibt aber ein Geknorze. Dann gibt es Model Baker, der die XTF-Datei in eine Datenbank importiert (GeoPackage oder PostgreSQL/PostGIS) und ein QGIS-Projekt mit Formularen erstellt. Das ist gut für die Erfassung von Daten aber weniger für einfach mal schnell Daten anschauen oder wenn man die Daten als Grundlage für andere Daten verwenden will. Da will ich mich nicht mit den gefühlt 1000 Importparametern rumschlagen müssen. Zudem dreht sich die Welt weiter? Wo bleibt Cloud Native INTERLIS? Eine Datei liegt auf einem Webserver, und die Anwendung liest nur jene Teile, die sie gerade benötigt. Zum Beispiel die Objekte im aktuellen Kartenausschnitt. Oder ein einzelnes Objekt und anschliessend die damit verknüpften Objekte. Ohne zuerst alles herunterzuladen und in eine Datenbank zu importieren. Das passt durchaus zum Grundgedanken von MDX. Dort steht ausdrücklich, dass Kodierungsregeln grundsätzlich für beliebige Datenformate definiert werden können. Warum also nicht eine binäre Kodierung, die die INTERLIS-Inhalte erhält und gleichzeitig einen direkten, selektiven Zugriff ermöglicht?
Genau dort setzt mein Experiment an: IBX – INTERLIS Binary eXchange.
Was IBX versucht
IBX soll die INTERLIS-Daten so aufbewahren, dass man sie sowohl vollständig lesen als auch gezielt auf einzelne Teile zugreifen kann. Ein Objekt anhand seiner ID, alle Objekte einer Klasse, ein ganzer Basket oder die Objekte in einem Kartenausschnitt. Und zwar lokal und über HTTP. Die Datei soll dabei alles mitbringen, was zum Lesen benötigt wird.
Die INTERLIS-Objekte bleiben mit ihren Attributen, verschachtelten Strukturen und Beziehungen erhalten. Ein Basket bleibt ein Basket und eine Referenz bleibt eine Referenz. Wer mehrere Geometrieattribute modelliert hat, soll diese auch wiederfinden. Die Daten werden also nicht zuerst in eine möglichst flache GIS-Tabelle gepresst.
Selbstredend muss der Roundtrip XTF → IBX → XTF verlustfrei funktionieren. Sonst wäre das Experiment für mich ziemlich schnell beendet. Verlustfrei bedeutet hier, dass die Inhalte und ihre INTERLIS-Bedeutung erhalten bleiben. Ob die XML-Datei nachher gleich eingerückt ist, interessiert mich weniger. Bei der Geometriekodierung gibt es allerdings ein paar Fragen, auf die ich gleich zurückkomme.
Aktuell unterstützt der Prototyp vollständige Transfers mit INTERLIS 2.3 und 2.4. Nachlieferungen beziehungsweise Update-Transfers sind noch nicht unterstützt. Ebenso macht eine Konversion nach IBX aus fehlerhaften Daten keine gültigen Daten: Die Erstellung ersetzt keine vollständige Modellvalidierung.
Falls sich der Ansatz bewährt, müsste das Ziel natürlich ein eCH-Standard sein. Eine binäre Kodierung, die formell und technisch gleichberechtigt neben dem bestehenden XML-Transferformat steht. INTERLIS beschreibt das konzeptionelle Modell. Warum sollte man dessen Daten nur auf eine Art übertragen können? Und bei der tatsächlichen Nutzung dürfte es dann gerne etwas erfolgreicher werden als INTERLIS/GML.
Wie das Format grundsätzlich funktioniert
Eine IBX-Datei besteht vereinfacht aus folgenden Teilen:
Header
Modell- und Transfermetadaten
Datenblöcke
Verzeichnisse und optionale räumliche Indizes
Footer
Der Header sagt dem Reader unter anderem, mit welcher Formatversion er es zu tun hat. Die Metadaten beschreiben die gespeicherten Klassen und Attribute und enthalten die Informationen, die zum Lesen der Objekte und zum Rückexport nach XTF benötigt werden. Dafür muss das ursprüngliche INTERLIS-Modell nicht erneut geladen und kompiliert werden. Zusätzlich können die originalen ILI-Dateien samt ihren Abhängigkeiten eingebettet werden.
Die eigentlichen Objekte werden mit CBOR binär kodiert. Wiederkehrende Namen, beispielsweise von Klassen und Attributen, stehen in einem Dictionary und werden über Nummern referenziert. Man muss also nicht bei jedem Objekt dieselben langen Bezeichnungen ausschreiben.
Mehrere Objekte werden zu Datenblöcken, sogenannten Chunks, zusammengefasst. Diese werden einzeln komprimiert. Das ist entscheidend: Um ein bestimmtes Objekt zu lesen, muss man nur den betreffenden Block laden und dekomprimieren. Ein einzelnes Objekt wird dabei nicht auf mehrere Blöcke verteilt. Sehr grosse Objekte ergeben entsprechend grosse Blöcke.
Wo das gesuchte Objekt liegt, verraten die Verzeichnisse. Sie ermöglichen den Zugriff über Objekt-ID, Basket, Klasse oder Topic. Für räumliche Abfragen kann zusätzlich ein Index erstellt werden. Dieser enthält die umschliessenden Rechtecke der Geometrien und liefert die Kandidaten für einen Kartenausschnitt. Eine exakte geometrische Verschneidung ist das noch nicht.
Der Footer am Dateiende verweist auf die Verzeichnisse und räumlichen Indizes. Ein Reader kann dadurch gezielt in die Datei einsteigen. Wer dagegen den gesamten Transfer lesen möchte, liest die Datenblöcke der Reihe nach. Diese Anordnung ist auch die Grundlage für den Zugriff über HTTP: Der Reader fordert die benötigten Bytebereiche an.
Bei den Geometrien gibt es zwei Profile. Das IOM-Profil speichert die Geometrien als INTERLIS-Objektstrukturen, wie sie auch die bestehenden INTERLIS-Werkzeuge verwenden. Koordinaten und Kreisbögen bleiben in dieser Darstellung erhalten. Es ist das Standardprofil und liegt nahe an der ursprünglichen INTERLIS-Abbildung.
Das WKB-Profil speichert die Geometrien als Well-Known Binary. Damit können GIS-Anwendungen direkter arbeiten; der QGIS-Provider verwendet dieses Profil. Die übrigen Attribute, Strukturen und Beziehungen bleiben weiterhin Bestandteil des INTERLIS-Objekts. Es wird auch keine zweite Geometriekopie mitgeschleppt. Unterstützte Kreisbögen werden als Kurven gespeichert und nicht segmentiert. Wir wollen ja nicht gleich alle Errungenschaften der Zivilisation über Bord werfen.
WKB klingt zunächst nach einer einfachen Entscheidung. Beim geforderten verlustfreien Roundtrip wird es aber interessanter. Lassen sich sämtliche benötigten INTERLIS-Geometrien damit ausdrücken? Bleiben die Koordinatenwerte exakt erhalten? Was passiert mit besonderen Linienformen oder expliziten Bogenradien?
Der Prototyp unterstützt deshalb einen abgegrenzten Umfang und prüft beim Erstellen die Rückkonversion der WKB-Geometrien. Was sich nicht verlustfrei abbilden lässt, wird abgelehnt. Es gibt keine stille Rundung, Segmentierung oder Geometriereparatur. Ob das WKB-Profil langfristig alle benötigten Fälle gleichwertig abdecken kann, gehört zu den Fragen, die vor einer Standardisierung geklärt werden müssen.
Eine Datei auf dem Webserver genügt
Wie sieht das nun konkret aus? Eine IBX-Datei liegt auf einem Webserver. Ich öffne sie in einer Anwendung und möchte einen bestimmten Kartenausschnitt sehen. Der Reader liest zuerst die grundlegenden Dateiinformationen und anschliessend die benötigten Teile des räumlichen Index. Damit findet er heraus, welche Objekte für den Ausschnitt infrage kommen und in welchen Datenblöcken diese liegen. Diese Blöcke werden geladen, dekomprimiert und die Objekte daraus gelesen.
Das funktioniert mit HTTP Range Requests. Der Client verlangt dabei bestimmte Bytebereiche einer Datei. Der Server muss weder INTERLIS verstehen noch räumliche Abfragen ausführen können. Die Auswertung der Indizes übernimmt der Client. Serverseitig genügt eine statische Bereitstellung, sofern der Server solche Bereichsabfragen korrekt unterstützt.
Dasselbe Prinzip funktioniert für ein einzelnes Objekt anhand seiner ID. Und wenn dieses Objekt auf ein anderes verweist, kann die Anwendung das referenzierte Objekt bei Bedarf nachladen. Dazu muss dessen Klasse nicht zuerst vollständig eingelesen werden. Genau das ist beispielsweise beim Erkunden von Beziehungen interessant.
Ganz gratis ist der Zugriff natürlich trotzdem nicht. Neben dem gesuchten Objekt werden Metadaten, Indexseiten und der Datenblock übertragen, in dem das Objekt steckt. Wie viel das ausmacht, hängt unter anderem von der Blockgrösse und der Anordnung der Objekte ab. Wenn räumlich benachbarte Objekte auch in der Datei nahe beieinanderliegen, müssen für einen Kartenausschnitt tendenziell weniger Blöcke geladen werden. Ein Cache hilft bei wiederholten Zugriffen. Cloud Native ist also auch hier keine Zauberformel.
Zudem darf sich die Datei nicht unbemerkt zwischen zwei Zugriffen ändern. Sonst liest man im schlimmsten Fall den Index der alten und die Datenblöcke der neuen Version. Der Prototyp sichert den Zugriff deshalb standardmässig mit einem starken HTTP-ETag ab. Alternativ kann eine URL ausdrücklich als unveränderlich behandelt werden, wenn die Bereitstellung das tatsächlich garantiert.
Ein Detail bleibt dabei wichtig: Ein Ausschnitt aus einem modellkonformen Datensatz ist nicht automatisch selber modellkonform. Wenn ich nur die Objekte im Kartenausschnitt exportiere, können beispielsweise referenzierte Objekte ausserhalb fehlen. Der selektive Zugriff ermöglicht das gezielte Lesen. Einen fachlich vollständigen, modellkonformen Auszug zusammenzustellen, ist eine zusätzliche Aufgabe.
IBX in QGIS
Der nächste logische Schritt ist die Implementierung in QGIS. Ein Anspruch ist die Benutzerfreundlichkeit. Und wahrscheinlich ist das der schwierigere Teil. Wie bringe ich die Beziehungen und Verschachtelungen so rüber, dass es nicht zu verwirrend ist? Keine Ahnung. Schauen wir uns ein kleines Modell an und wie das in QGIS funktionieren könnte.
INTERLIS 2.4;

!!@ ibx.label = "Parkanlage"
MODEL Parkanlage (de) AT "https://example.org/ibx/demo" VERSION "2026-09-23" =

  DOMAIN
    LV95 = COORD 2480000.000 .. 2850000.000, 1070000.000 .. 1300000.000;

  TOPIC Park =
    !!@ ibx.label = "Messwert"
    STRUCTURE Messwert =
      Merkmal : MANDATORY TEXT*80;
      Wert : -999999999999.000000 .. 999999999999.000000;
      Einheit : TEXT*20;
    END Messwert;

    !!@ ibx.label = "Kontrolle"
    STRUCTURE Kontrolle =
      Datum : INTERLIS.XMLDate;
      Ergebnis : (inOrdnung, beobachten, MassnahmeNoetig);
      Bemerkung : TEXT*200;
      Messwerte : LIST {0..*} OF Messwert;
    END Kontrolle;

    !!@ ibx.label = "Spielplatz"
    !!@ ibx.titleAttribute = "Name"
    CLASS Spielplatz =
      Name : MANDATORY TEXT*100;
      Flaeche : SURFACE WITH (STRAIGHTS) VERTEX LV95 WITHOUT OVERLAPS > 0.001;
    END Spielplatz;

    !!@ ibx.label = "Spielgerät"
    !!@ ibx.titleAttribute = "Name"
    CLASS Spielgeraet =
      Name : MANDATORY TEXT*100;
      Typ : (Schaukel, Rutschbahn, Kletterturm, Wippe);
      Zustand : (gut, pruefen, ersetzen);
      Position : LV95;
      Kontrollen : LIST {0..*} OF Kontrolle;
    END Spielgeraet;

    !!@ ibx.label = "Spielplatz-Zuordnung"
    ASSOCIATION SpielplatzZuordnung =
      !!@ ibx.label = "Spielgeräte"
      Spielgeraete -- {0..*} Spielgeraet;
      Spielplatz -- {1} Spielplatz;
    END SpielplatzZuordnung;
  END Park;
END Parkanlage.
Für QGIS gibt es ein experimentelles Plugin, das man als ZIP-File installieren kann. Das Plugin kann .ibx-Dateien laden und Objekte abfragen. Es liefert auch zwei .ibx-Demo-Dateien mit, die einfach via Menu geladen werden können:
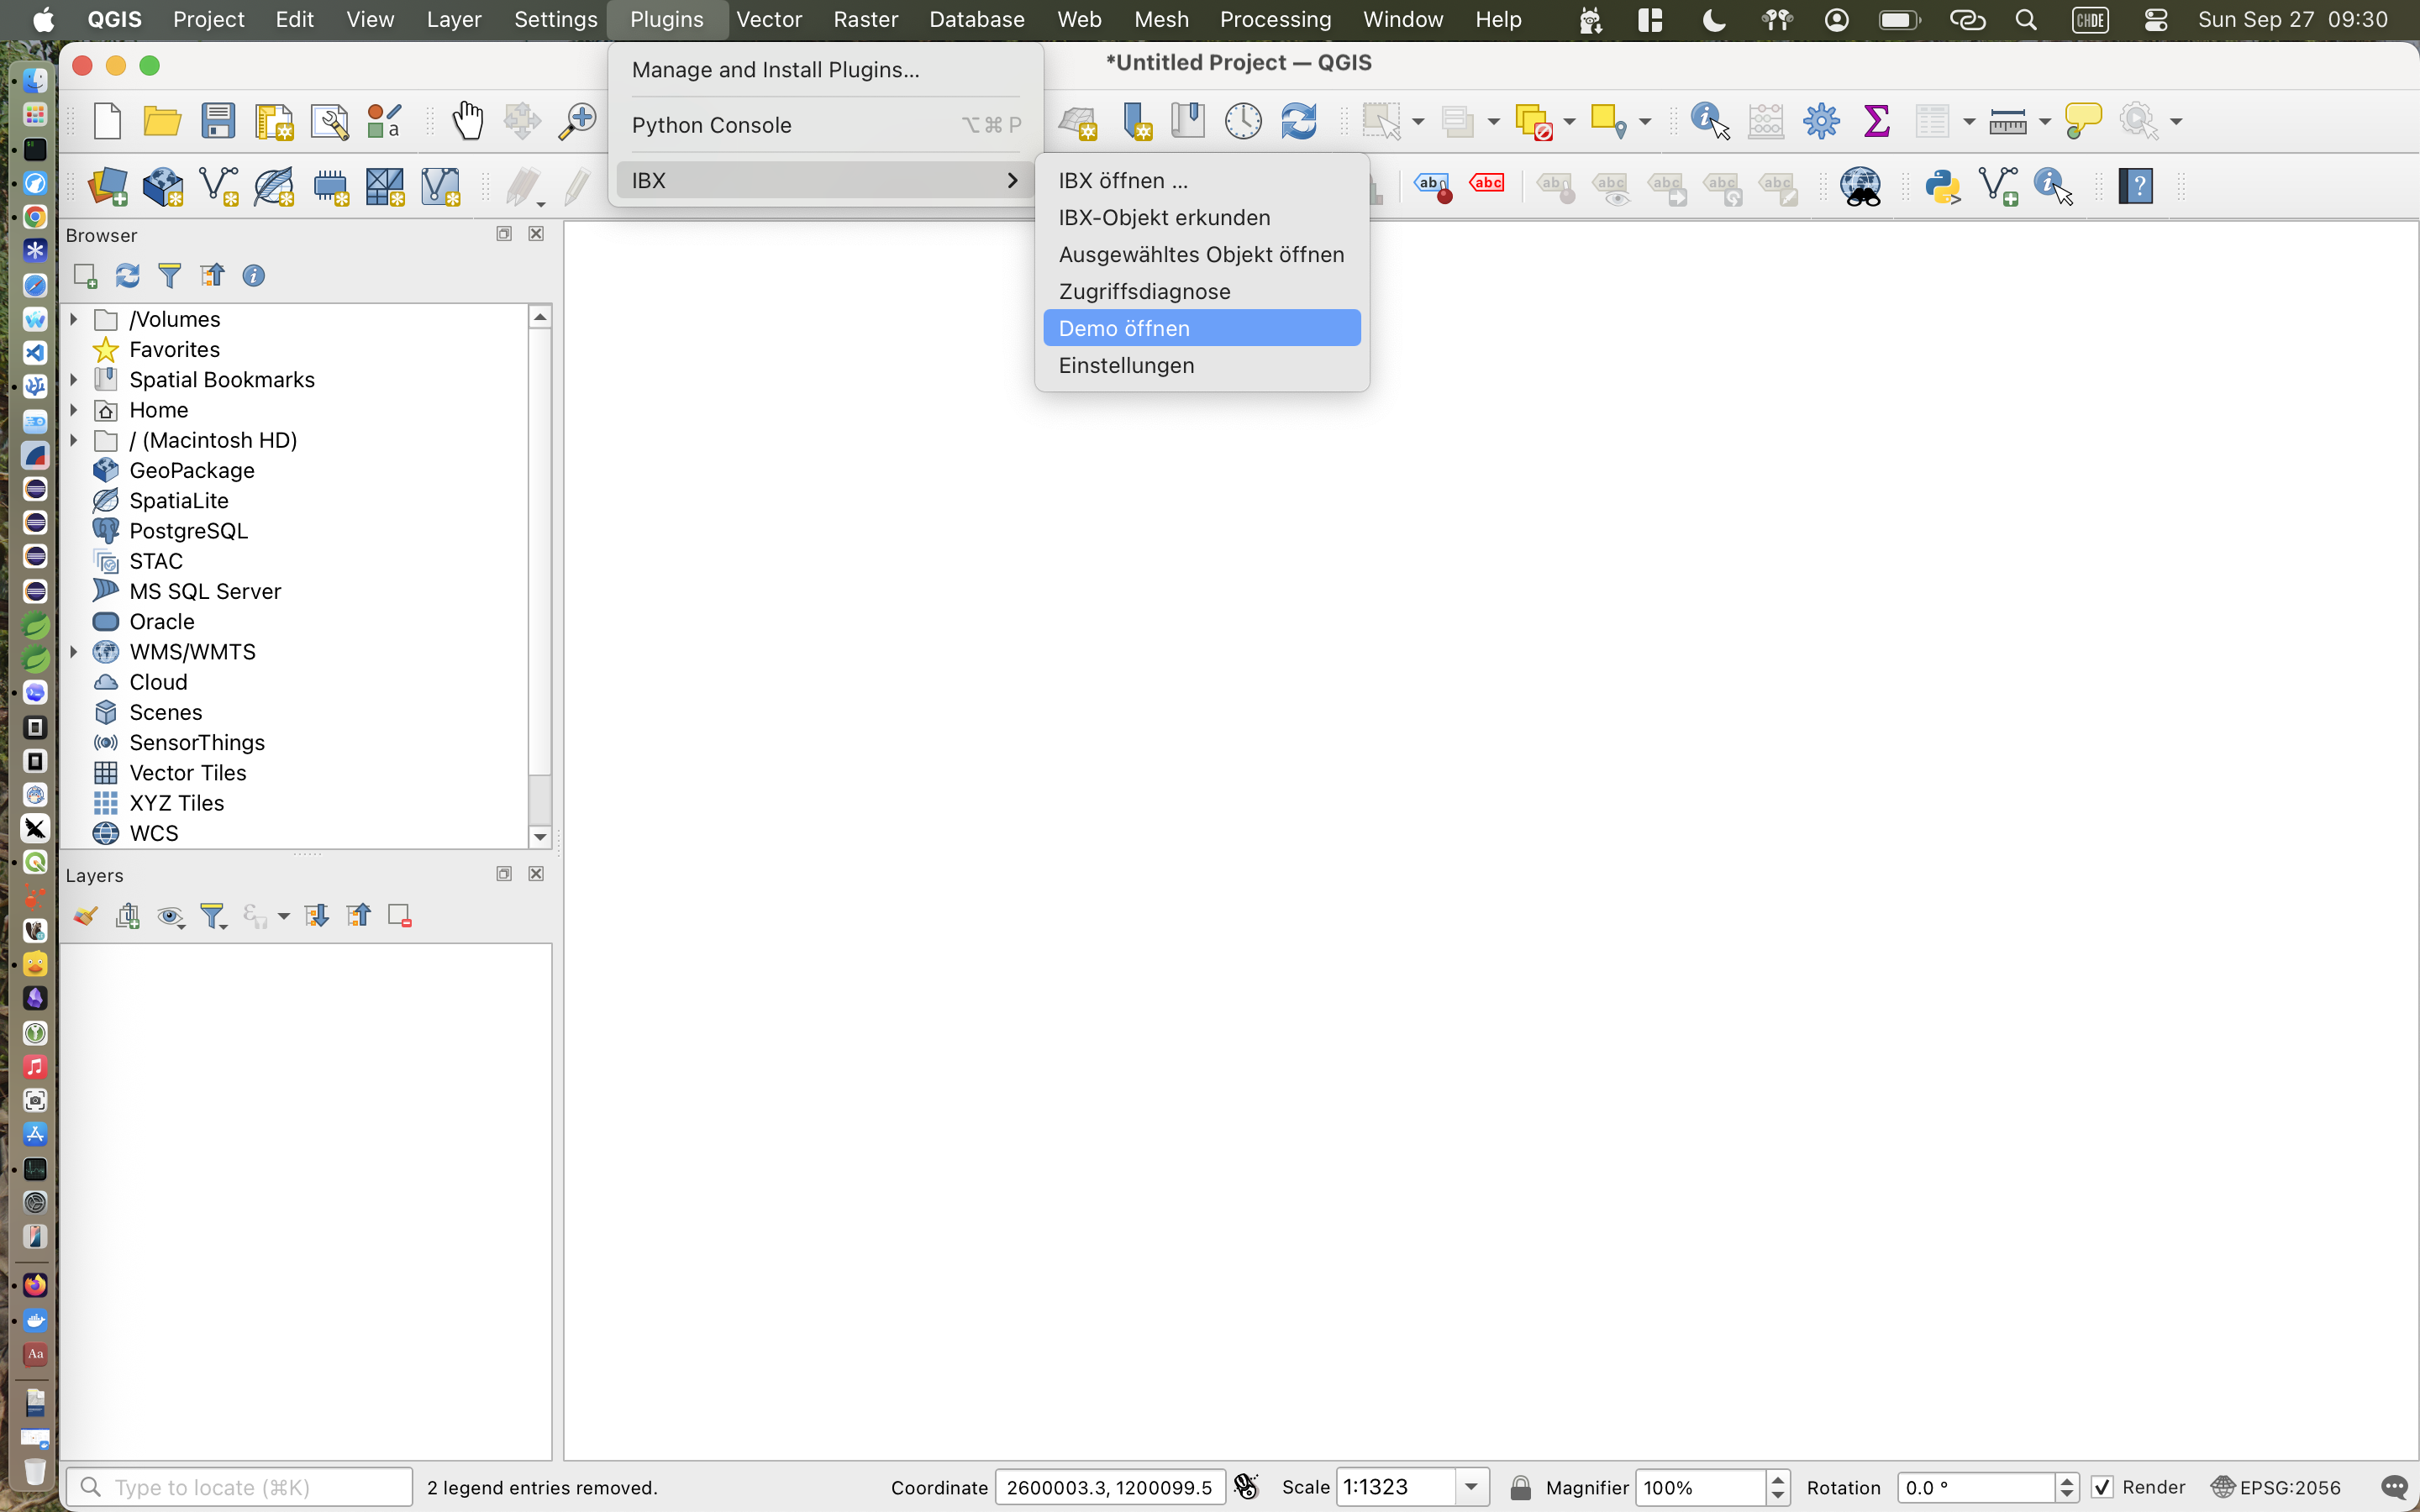
Am besten wählt man die einfachere der beiden: «Parkanlagen». Anschliessend erscheint die Auswahl der Layer:
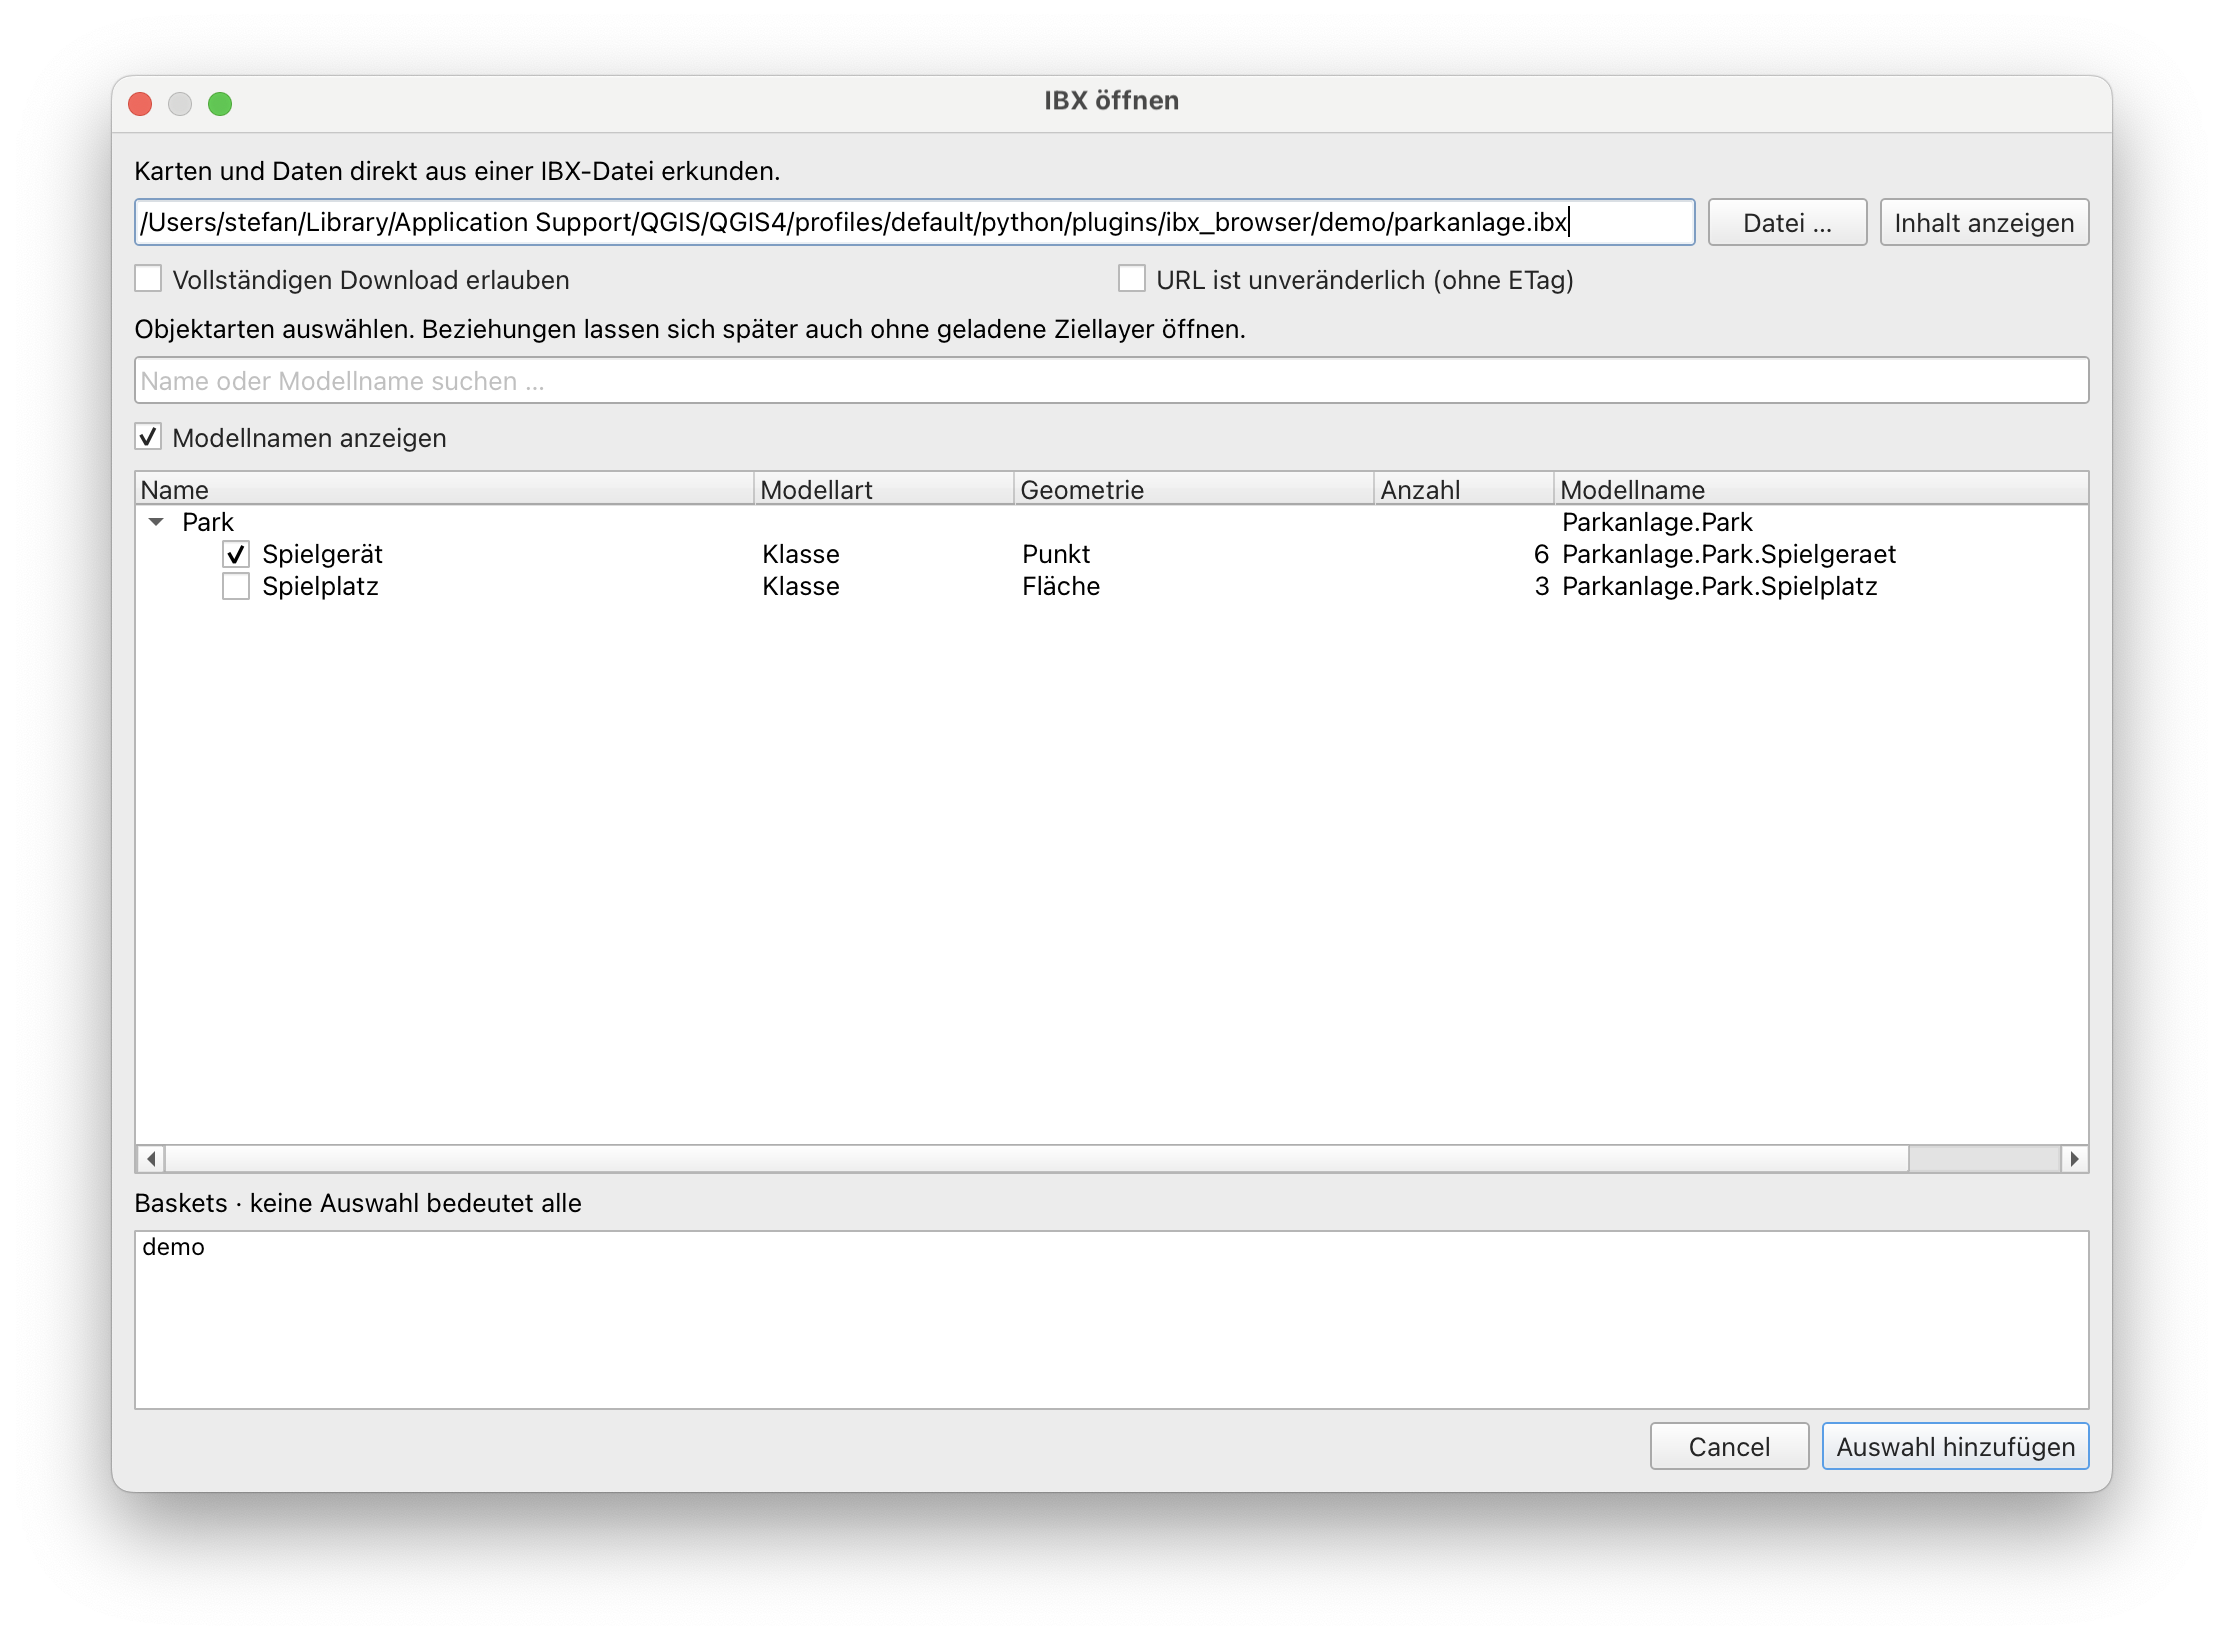
In unserem einfachen Fall gibt es nur zwei Klassen, die geladen werden können. Wenn wir beide wählen, erscheinen sie normal als Layer in QGIS:
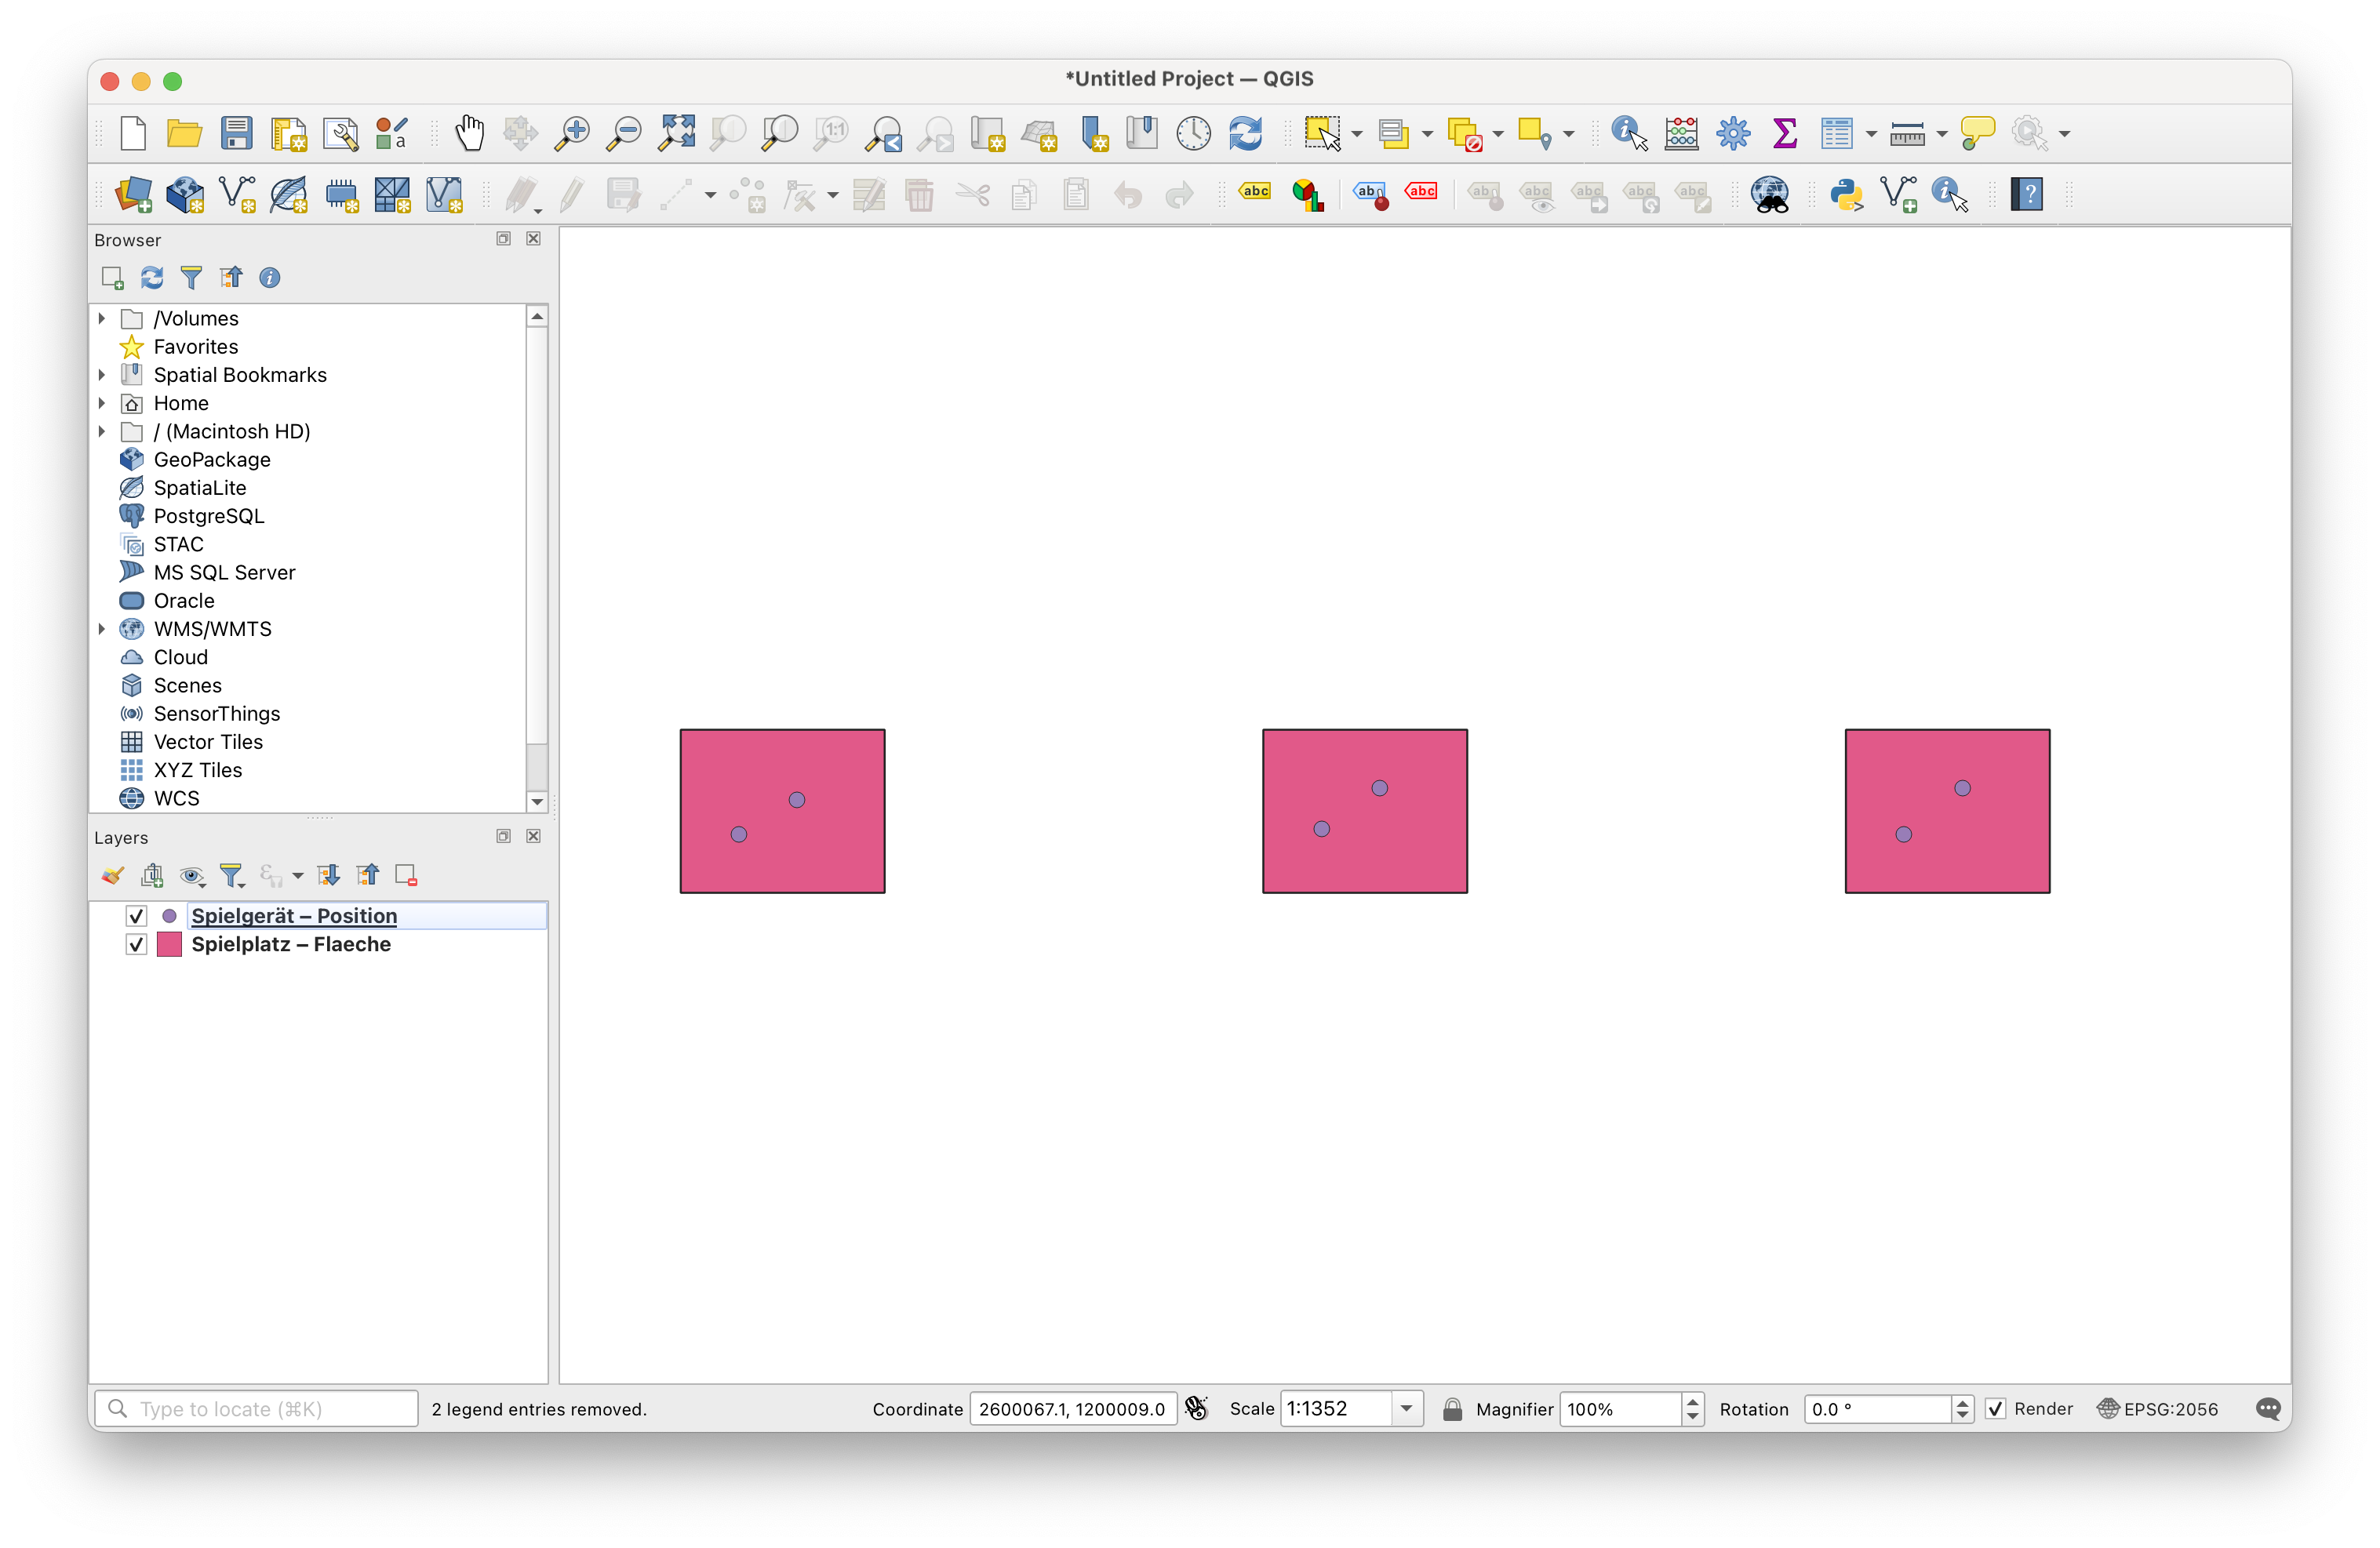
Spannend wird es nun, wenn man Objekt abfragen will. Dazu wählt man unter Plugins → IBX → IBX-Objekte erkunden. Wenn man nun auf ein Objekt klickt, öffnet sich ein spezielles Fenster:
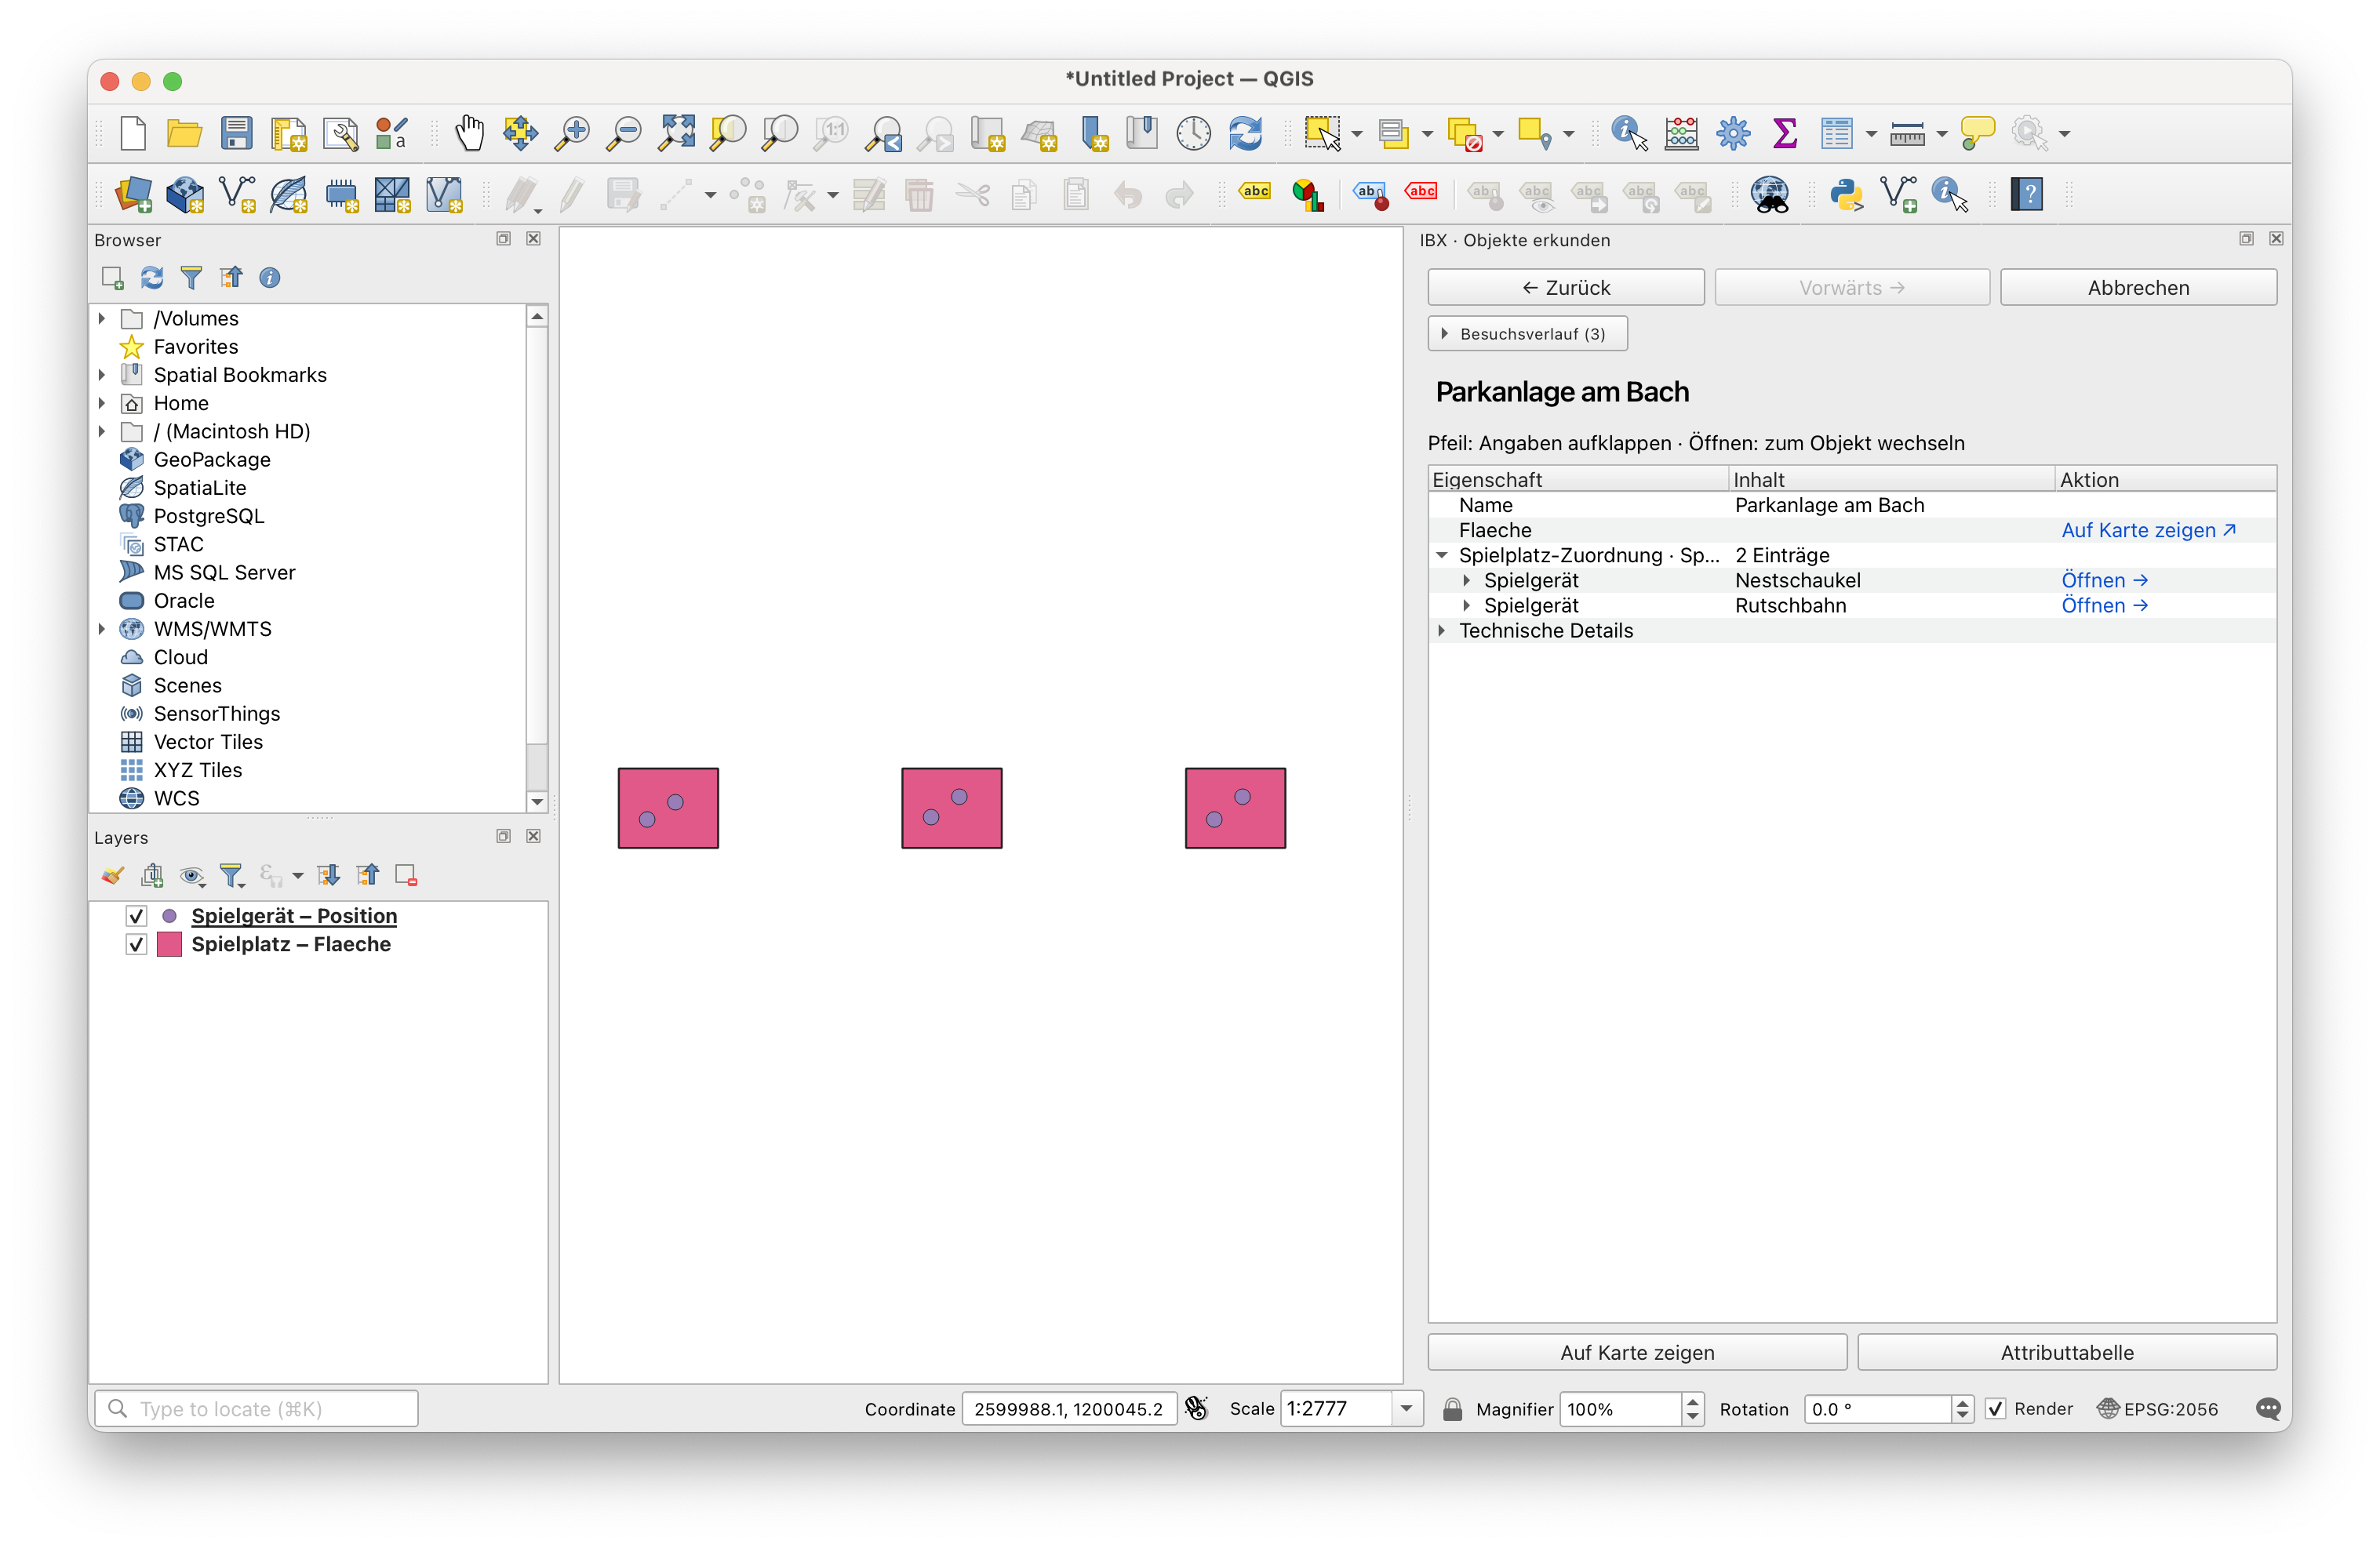
Die Objektinformation zeigt uns die zwei «normalen» Attribute Name und Flaeche. Zusätzlich die ihm zugeordneten Spielgeräte. Diese kann man aufklappen und man erkennt auch die Listen von Strukturen wieder:
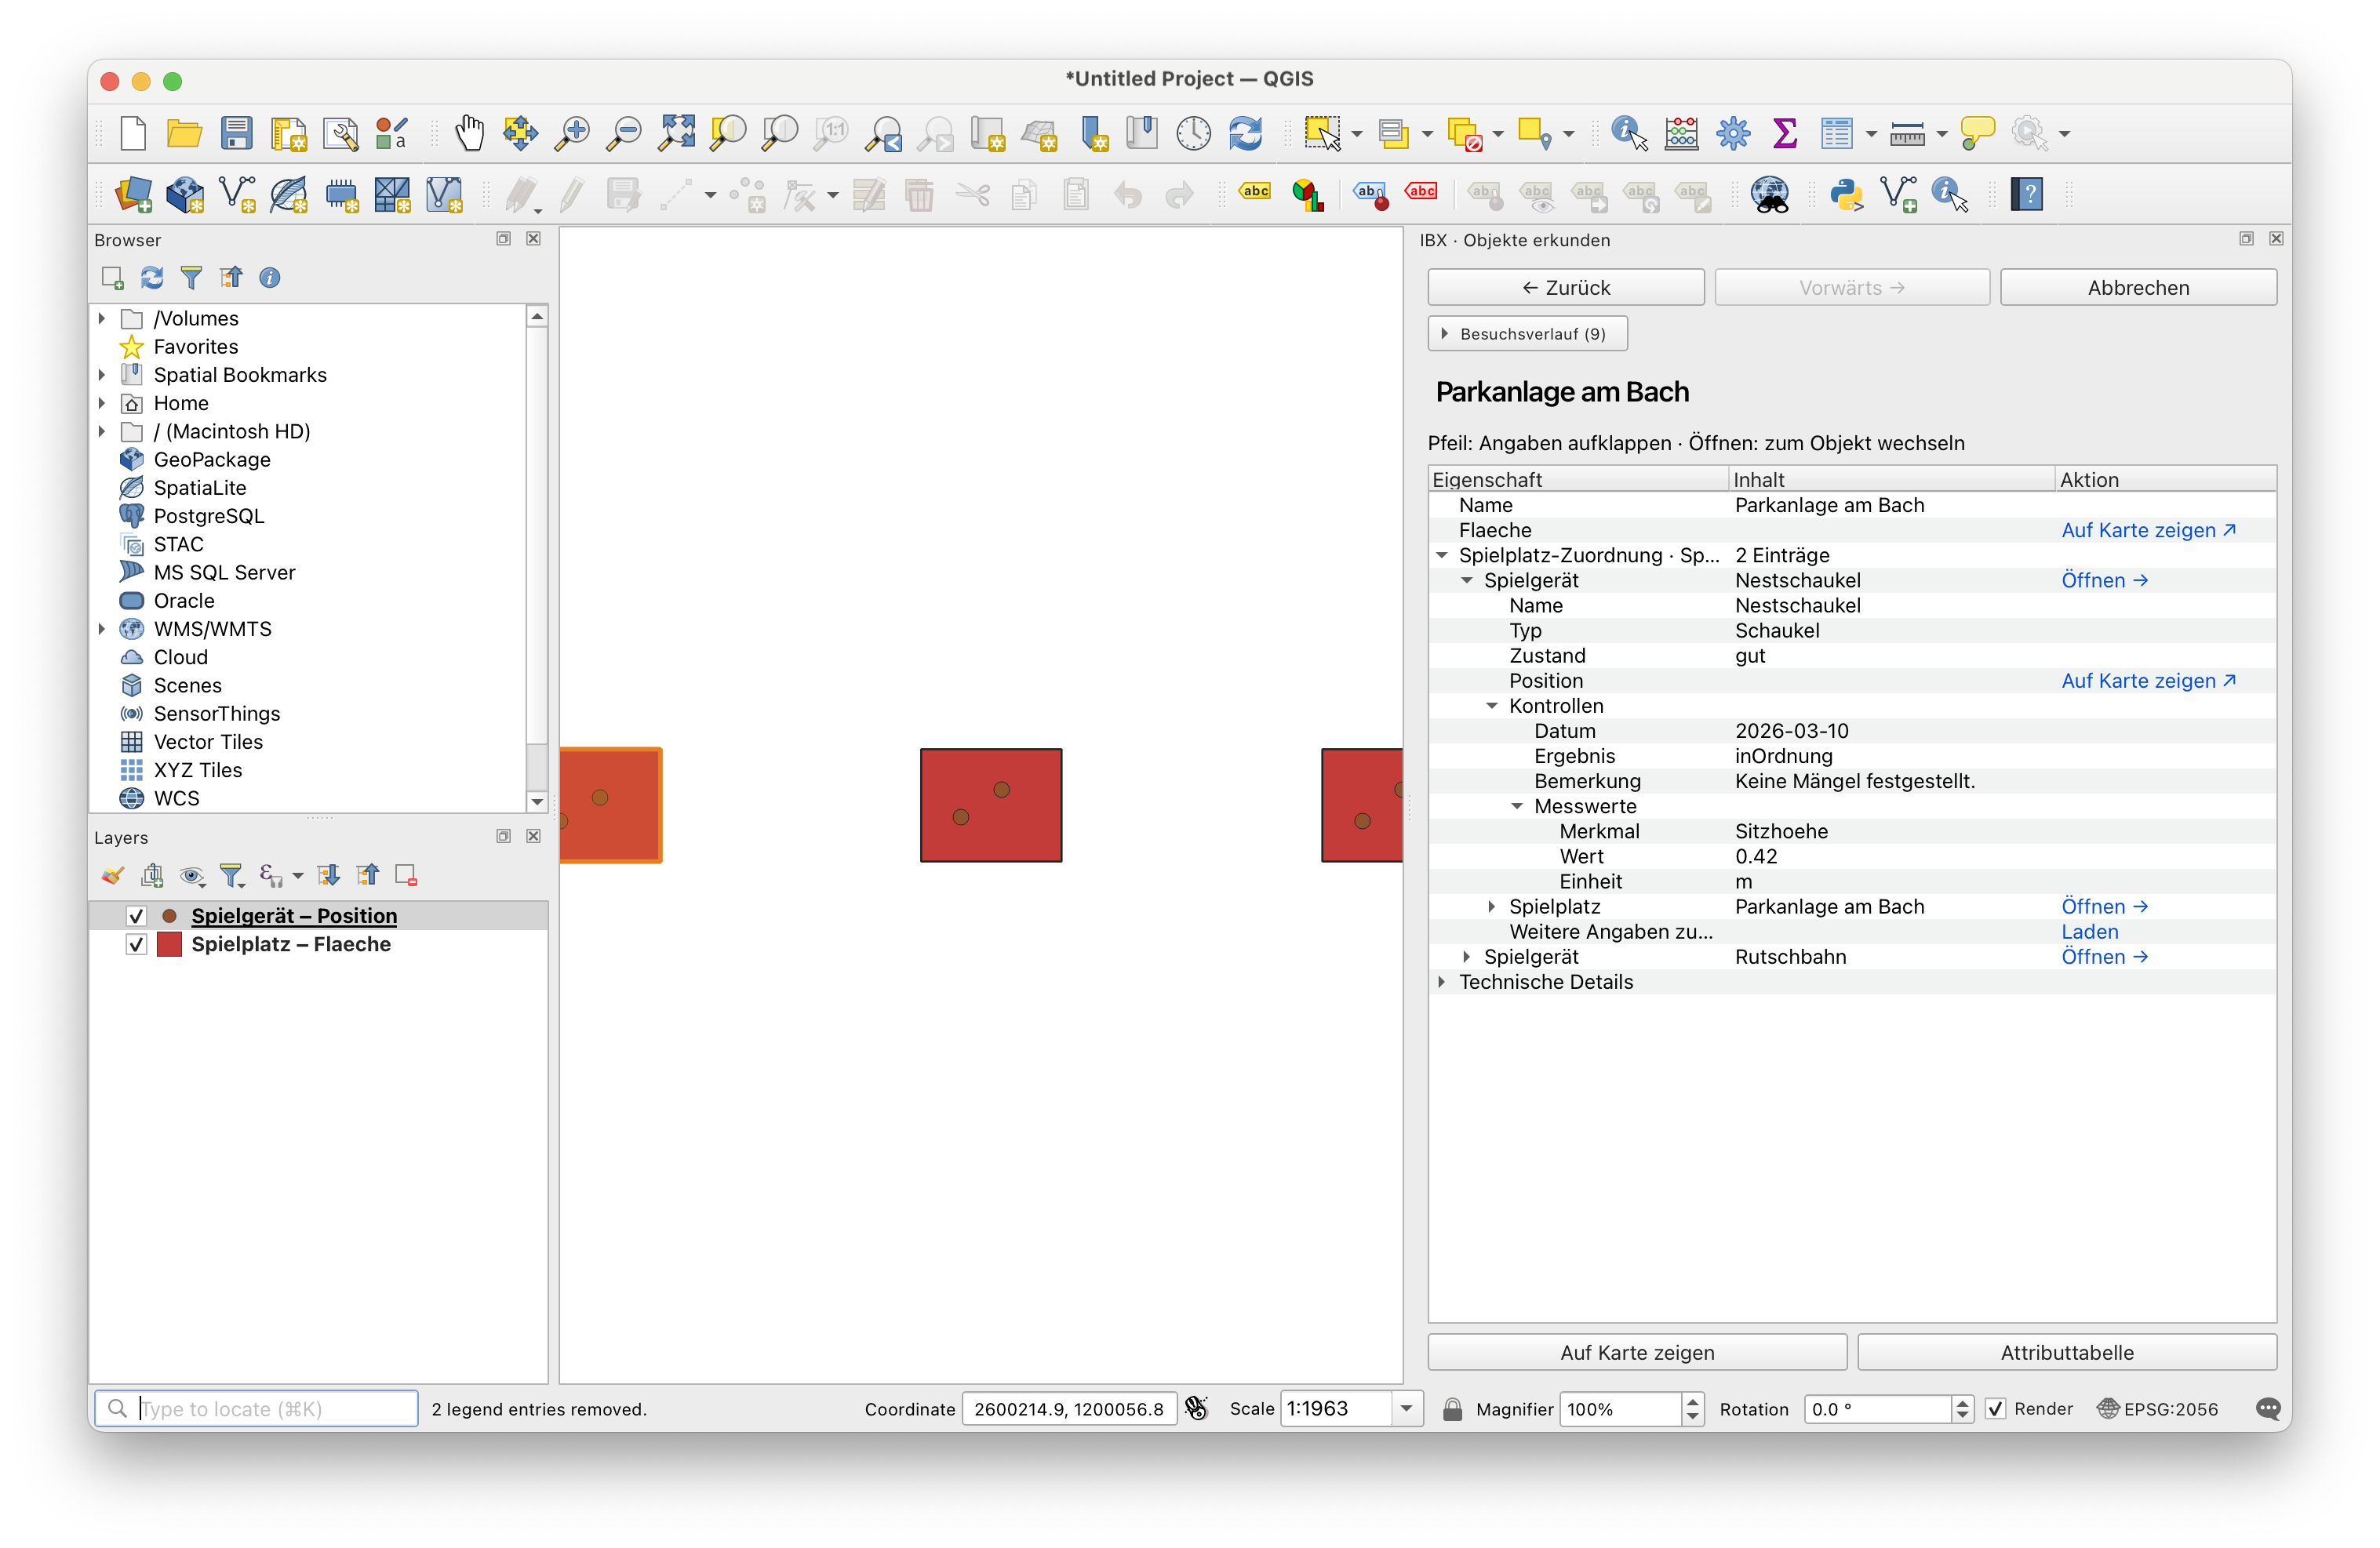
Momentan unterscheidet der Browser noch zwischen Rückwärts- und Vorwärtsnavigation. Das scheint mir unnötig inkonsistent zu sein und müsste verbessert werden. Was heisst das? Wenn ich den Layer Spielgerät lade, escheint im Browser bei einer Objektabfrage noch nicht der Spielplatz, dem das Gerät zugewiesen ist.
In diesem einfach Beispiel mag das alles noch übersichtlich erscheinen. Aber schon die zweite Demo «Quartier und Unterhalt» zeigt, dass es schnell herausfordernd wird. Hier müsste man definitiv noch einiges an Hirnschmalz investieren, um das wirklich benutzerfreundlich hinzukriegen.
Selber ausprobieren
Ihr könnt das alles selber ausprobieren. Das Plugin habe ich oben verlinkt. Ihr findet ein CLI-Tool, das aus einer XTF-Datei eine IBX-Datei erstellt. Beispielbefehl:
./bin/ibx create \
  demo/parkanlage.xtf \
  build/parkanlage.ibx \
  --model-file demo/Parkanlage.ili \
  --geometry-encoding wkb \
  --geometry-crs Parkanlage.Park.Spielplatz.Flaeche=EPSG:2056 \
  --geometry-crs Parkanlage.Park.Spielgeraet.Position=EPSG:2056 \
  --spatial Parkanlage.Park.Spielplatz:Flaeche \
  --spatial Parkanlage.Park.Spielgeraet:Position \
  --crs EPSG:2056 \
  --embed-models \
  --overwrite
Das erzeugt build/parkanlage.ibx mit WKB-Geometrien und räumlichen Indizes für Spielplätze und Spielgeräte – passend für den QGIS-Plugin-Prototyp.
Um Daten aus einer GeoPackage-Datei oder PostgreSQL-Datenbank in eine IBX-Datei zu exportieren, gibt es ein gepatchtes ili2db:
java -jar "/pfad/zum/entpackten/ili2gpkg-5.5.3-ibx.2.1.jar" \
  --export \
  --dbfile "./data/parkanlage.gpkg" \
  --models "Parkanlage" \
  --modeldir "./demo" \
  --ibxGeometryEncoding wkb \
  --ibxGeometryCrs Parkanlage.Park.Spielplatz.Flaeche=EPSG:2056 \
  --ibxGeometryCrs Parkanlage.Park.Spielgeraet.Position=EPSG:2056 \
  --ibxSpatial Parkanlage.Park.Spielplatz:Flaeche \
  --ibxSpatial Parkanlage.Park.Spielgeraet:Position \
  --ibxCrs EPSG:2056 \
  --ibxEmbedModels \
  --ibxOverwrite \
  "./build/parkanlage.ibx"
Und weil es einen IBX-IoxReader gibt, könnte man auch ganz einfach ilivalidator ibx-ready machen und die Ökosystem-Kette ist vollständig.
Experiment mit offenen Enden
IBX ist ein Experiment. Das bedeutet auch, dass die erste Umsetzung nicht automatisch die beste ist. Manche Entscheidungen sehen auf dem Papier vernünftig aus, bis man einen grösseren Datensatz damit verarbeitet.
So wurden die Dateien bei vielen Punktgeometrien unerwartet gross. Die eigentlichen Punkte brauchen vergleichsweise wenig Platz. Wenn dann die Verwaltung und insbesondere der räumliche Index einen beträchtlichen Teil der Datei ausmachen, muss man nochmals über die Bücher. Wir haben dort bereits nachgebessert.
Eine möglichst kleine Datei ist allerdings nur eines der Ziele. Ein komprimiertes XTF kann sehr kompakt sein. Damit habe ich aber noch keinen schnellen Zugriff auf ein einzelnes Objekt oder einen Kartenausschnitt. Bei IBX kosten die dafür benötigten Indizes zusätzlichen Platz. Interessant ist deshalb auch, wie viele Bytes und HTTP-Anfragen für eine konkrete Abfrage nötig sind. Dateigrösse, Blockgrösse, Datenanordnung und Zugriffsgeschwindigkeit muss man zusammen anschauen.
Offen bleibt ebenfalls, wie weit wir mit dem WKB-Profil kommen. Für die unterstützten Geometrien wird der verlustfreie Rückweg geprüft. Ob damit sämtliche benötigten INTERLIS-Geometrien sinnvoll abgedeckt werden können, muss sich noch zeigen. Der Anspruch an den Roundtrip bleibt bestehen. Die Kodierung muss diesen Anspruch erfüllen.